


LAPRAS の森元です。AI LAB でのはじめての投稿になります。私は、修士課程・博士課程を通して自然言語処理学の研究をしてきました。特に推論や因果関係に興味があり、主に含意関係認識の研究を行ってきています。先月4月よりリサーチャーとして LAPRAS に入社しました。
本記事は、2019年4月現在の文自動生成に関してのサーベイを行った結果をまとめたものです。
はじめに
LAPRAS の提供している LAPRAS SCOUT では、スカウトメール作成支援システムを導入しています。現在は、候補者情報とテンプレートを用いたスカウトメール作成支援システムを導入していますが、よりメール作成のコスト削減を目指すために、文の自動生成を用いることができないかと考えました。そこで、文の自動生成に関する研究がどのような現状であり、その技術が我々のプロダクトに使えるものであるのかという視点で調査を行いました。
文生成について
まず、文生成と応用利用されるタスクについてまとめます。文生成とは、文・画像・その他諸々の表現を入力として、最終的に自然言語文を出力とする処理のことを言います。文生成の技術は様々な応用タスクで用いられています。
文生成タスクの応用例
| タスク | 入力 | 出力 | 例 |
|---|---|---|---|
| 質問応答文生成 | 文(+画像) | 文 | 質問文に対する応答の生成。 |
| 論文例:Learning surface text patterns for a Question Answering system | |||
| 論文例:VQA: Visual Question Answering | |||
| 対話応答生成 | 文 | 文 | 発話に対する応答文の生成。 |
| 論文例:自己相互情報量を用いた特徴語彙予測に基づく雑談応答生成 | |||
| 論文例:Learning to Control the Specificity in Neural Response Generation | |||
| 自動文書要約生成 | (複数)文書 | 文、短い文書 | 記事などの文書から、要約した短い文または文書の生成。 |
| 単語数などで生成文長の制限が可能。 | |||
| 論文例:A Neural Attention Model for Abstractive Sentence Summarization | |||
| キャプション生成 | 画像、動画 | 文 | 画像や動画に対するキャプションの生成。 |
| 論文例:物体間の関係性を考慮したTransformerに基づくキャプション生成 | |||
| キャッチコピー生成 | 文書 | 文 | Wantedlyの募集要項文書からキャッチコピーの生成。 |
| 論文例:対象に固有な特徴を捉えたキャッチコピー生成 | |||
| 論述生成 | 論題 | 論述文書 | 論文例:論述構造との同時予測による論述的な意見生成 |
| 俳句生成 | ランダム値または季語 | 俳句 | 画像にマッチした俳句の生成。 |
| 論文例:LSTMを用いた俳句自動生成器の開発 | |||
| 歌詞生成 | 音数、メロディ | 歌詞 | 音数、メロディなどを条件に歌詞を生成 。 |
| 論文例:メロディ条件付き歌詞⾔語モデル |
文生成に用いられるデータセットについて
文生成に用いるデータセットは、何を生成したいか(応用タスク)によって異なります。文生成に利用可能であるデータセットを日本語と英語に分けて以下にまとめました。
生成に利用できそうなデータセット例
日本語データセット
| 名前 | 利用タスク | サイズ | 概要・その他 |
|---|---|---|---|
| twitter発話応答(メンション)データ | 対話 | 利用者ごとにクロールして利用。 | |
| 青空文庫形態素解析データ集 | 著者特徴をもつ文生成 | 11,176作品 | 青空文庫の(著作権の切れた)作品に対して形態素解析を行ったデータ。商標利用も可。 |
| 自然言語処理のためのリソース(京大) | いろいろ | 毎日新聞、Web文書のリード文などのデータセット群。 | |
| RITE-VAL | 含意関係認識 | 約1400文対 | 前提・仮説のペアに対して含意関係有り(Y)/なし(N) の2タグを付与。※使用条件あり。 |
英語データセット
| 名前 | 利用タスク | サイズ | 概要・その他 |
|---|---|---|---|
| The Ubuntu Dialogue Corpus | 対話 | 449,071対話 | Ubuntuのテクニカルサポートの対話データ。1対1対話。長めのターン数(平均7.7ターン)。 |
| CNN/DailyMail dataset | 要約 | 約31万文対 | CNNおよび DailyMail の記事とその要点をまとめた人が作成した幾つかのセンテンス(参照要約)がペアになっている。 |
| 平均記事長:781語、平均要約文数:3.75文 | |||
| DUC Corpus 2004 | 要約 | 要約タスクのための3つのデータセットが収録。ベースラインとなるアルゴリズムによる要約結果も収録されており、それらのROUGEスコアとの比較が簡単に可能。 | |
| SQuAD | 質問応答 | 15万対 | Stanford Question Answering Dataset。読解力を重視したタスクのためのデータセット。Wikipedia記事のテキスト、質問、解答 の3つで1セット。 |
| bAbI | 質問応答、対話、言語モデル、etc... | Facebook AI Researchが進める自然言語理解のためのプロジェクト(bAbI)で利用されているデータセット。 | |
| SNLI | 自然言語推論 | 約60万文対 | Standord Natural Language Inference。前提・仮説のペアに対して entailment(含意), contradiction(矛盾), neutral(どちらとも言えない) の3タグを付与。 |
文生成でよく用いられる手法
文生成の研究によく用いられる手法についてまとめます。本記事では、各手法やモデルの詳しい説明は省きます。詳しく知りたい方は各リンクの論文等を参照してください。
- 深層学習を用いた Encoder-Decoder モデルを用いるのが主流
- Encoder-Decoder モデル + α により新規性を足している手法が多い
- 内部のニューラルネットワークには LSTM が用いられることが多い
- 文の自動生成における基本的アプローチの考え方は機械学習技術と同じ
- 日本語での研究では、現在もテンプレートに穴埋めを行う手法を用いた生成モデルも多い(※肌感)
評価指標
文生成の研究においてよく用いられる評価指標について、自動評価と人手評価でそれぞれまとめます。
自動評価
- BLEU:機械翻訳の分野において、最も一般的な自動評価基準。n-gram 単位でのマッチ率に基づく手法を用いている。
\mathrm{BLEU}=e^{(1−r/c)}\exp(\sum^{N}_{n=1}w_n\log p_n)
- ROUGE-N:要約の分野において、最も一般的な自動評価基準。BLEU を参考に編み出された指標。
\mathrm{ROUGE}_N=\frac{\sum_{S\in\mathrm{references}}\sum_{\mathrm{gram}_n\in S}\mathrm{Count_{matched}}(\mathrm{gram}_n)}{\sum_{S\in\mathrm{references}}\sum_{\mathrm{gram}_{n}\in S}\mathrm{Count}(\mathrm{gram}_{n})}
- NIST:BLEU と同様に n-gram 単位でのマッチ率を用いた手法。情報量によって重み付けしている点が異なり、より文長を考慮するようにペナルティが計算される。
\mathrm{NIST}=\exp(\beta\log^2\bigl[\mathrm{min}(\frac{L_{\mathrm{sys}}}{L_{\mathrm{ref}}}), 1\bigr] )
\times\sum^{N}_{n=1}
\frac{\sum_{\mathrm{all}\hspace{1pt} w_1…w_n \hspace{1pt}\mathrm{in} \hspace{1pt} \mathrm{sys}\hspace{1pt} \mathrm{output}}
      \mathrm{Info}(w_1…w_n)
      }
      {\sum_{\mathrm{all} \hspace{1pt}w_1 … w_n \hspace{1pt}\mathrm{in} \hspace{1pt}\mathrm{sys}\hspace{1pt} \mathrm{output}}}
- METEOR:参照訳と出力のユニグラムの合致数をもとにした評価尺度。BLEU の弱いところに勝つような自動評価尺度を目指している。
- F値の計算。適合率と再現率の調和平均。(下記式では適合率1:再現率9)
\mathrm{Fmean}=\frac{\mathrm{Precision}\times\mathrm{Recall}}{\alpha\times\mathrm{Recall}+(1-\alpha)\times\mathrm{Precision}}- ペナルティの計算。正解の単語列が続かない場合にペナルティが大きくなる。
\mathrm{Penalty}=0.5\times\biggl( \frac{\mathrm{\#\hspace{1pt}chunks}}{\mathrm{\#\hspace{1pt}unigrams\_matched}}\biggr) ^3- 最終的な METEOR スコアはF値とペナルティを用いて下記式で計算される。
\mathrm{METEOR}=\mathrm{Fmean}\times(1−\mathrm{Penalty}) - TER:Translation Edit Rate。翻訳のエラー率を算出するための自動評価尺度。参照を得るために、翻訳結果に対して行う修正の割合を算出。スコアが低いほどエラーが少ない。
\mathrm{TER}=\frac{\mathrm{\# \hspace{1pt}of \hspace{1pt}edits}}{\mathrm{average} \hspace{1pt}\mathrm{ \# \hspace{1pt}of \hspace{1pt}reference \hspace{1pt}words}}
- etc.
人手評価
- ランク付評価指標:システムの出力と人手作成の出力を混ぜてランキングを付けてもらい評価
- 適正評価指標:システムへの入力と出力を見せて評価
- 特性評価指標:システムの出力と人手作成の出力を比較して評価(より具体的・情報量が多いのはどちらか等)
- etc.
文生成の研究例
ACL2018での文生成系研究
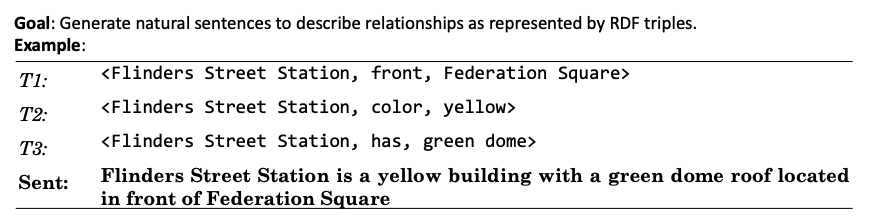
GTR-LSTM: A Triple Encoder for Sentence Generation from RDF Data [B. D. Trisedya+, ACL18]
- 概要:RDF トリプルデータ(例:1つの建物に関して、front, color, has 情報を持つデータ)から文を生成。
- 手法:GTR-LSTM モデルを提案。トリプルデータの構造情報も学習可能なモデル。
- 結果:BiLSTM と提案手法を比較すると、各データでスコアの向上が見られた。
- WebNLG データセットで、BLUE:17.6%、METEOR:6.0%、TER:16.4% のスコア向上
- GKB データセットで、BLUE:15.2%、METEOR:20.9%、TER:23.1%のスコア向上
Soft Layer-Specific Multi-Task Summarization with Entailment and Question Generation [Han Guo+, ACL18]
- 概要:マルチタスクで学習して、要約生成の state-of-the-art。マルチタスク学習アプローチを提案。
- 手法:2層の BiLSTM-RNN エンコーダ + 2層の uniLSTM-RNN デコーダモデルを用いて、抽象要約・質問生成・含意生成タスクを並行して学習を行う。
- 結果:提案手法により state-of-the-art の大幅向上がみられた。
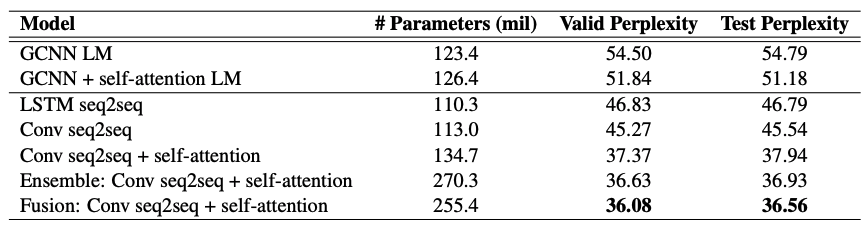
Hierarchical Neural Story Generation [Angela Fan+, ACL18]
- 概要:Writing Prompts Dataset を用いたストーリー生成。階層的なストーリー生成を可能にした。
- 手法:Seq2Seq モデルを長距離の文脈を参照できるように改良。
- 階層的なストーリー生成のために、畳み込み言語モデルで premise または prompt を生成
- 畳み込みモデルを用いた Seq2Seq で prompt をストーリに変換
- 2つの Seq2Seq モデルを利用して、最初のモデルの学習に失敗した部分を2番目のモデルが重点的に学習。
- 結果:
Unsupervised Discrete Sentence Representation Learning for Interpretable Neural Dialog Generation [Tiancheng Zhao+, ACL18]
- 概要:対話生成における、教師なし離散文表現学習法による VAE の改善。
- 手法:Discrete Information を用いた VAE の改善を提案。
- DI-VAE:Discrete Information VAE
- DI-VST:Discrete Information Variational Skip Thought
- 結果:いくつかのデータセットでの実験すべてにおいて VAE よりよいスコア。
Learning to Control the Specificity in Neural Response Generation [Ruqing Zhang+, ACL18]
- 概要:Gaussian Kernel 層を用いた特異性制御変数を導入して、特異性の大きさを変えた対話応答を生成。
- 手法:Seq2Seq に特異性制御変数を加えたモデル
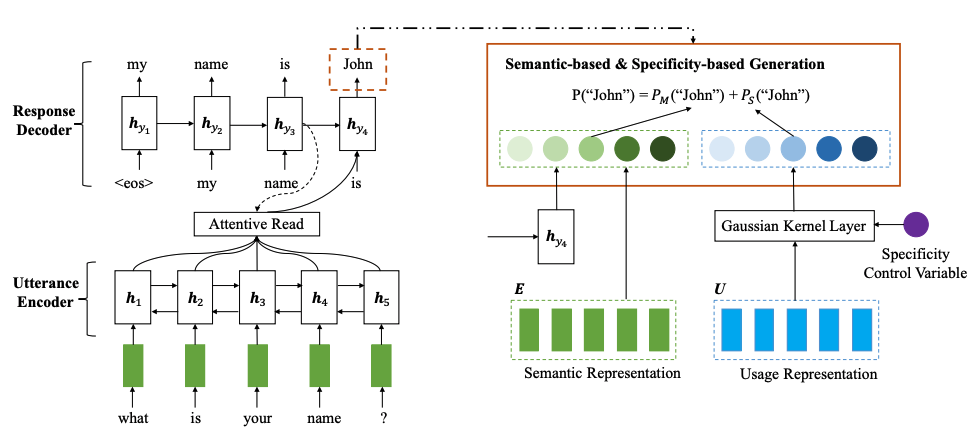
- 結果:Short Text Conversation で state-of-the-art。従来手法より特異性をもたせた応答文が生成できた。
A Graph-to-Sequence Model for AMR-to-Text Generation [Linfeng Song+, ACL18]
- 概要:AMRグラフから意味情報を保ったままテキストを生成するモデルを提案。
- 従来手法の Seq2Seq モデルでは AMR のグラフ構造の情報が消失。
- 大きなグラフでは長いセンテンスが生成されてしまう問題。
- グラフレベルの意味情報を直接エンコードする新しい LSTM 構造を提案。
- AMR:Abstract Meaning Representation。抽象的意味表現。
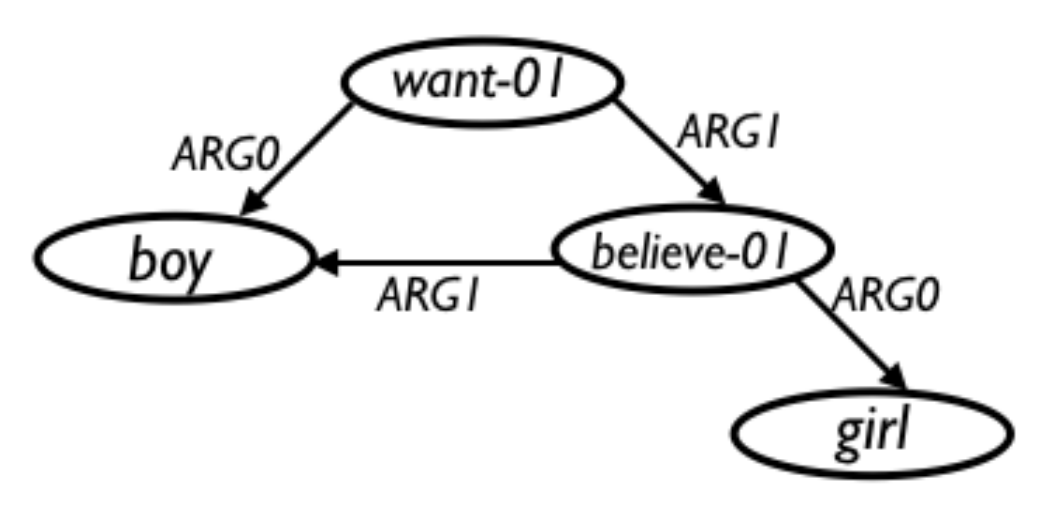
(w/want-01 :ARG0(b/boy) :ARG1(b2/believe-01 :ARG0(g/girl) :ARG1 b)) - 従来手法の Seq2Seq モデルでは AMR のグラフ構造の情報が消失。
- 手法:Graph-to-Sequenceモデル。
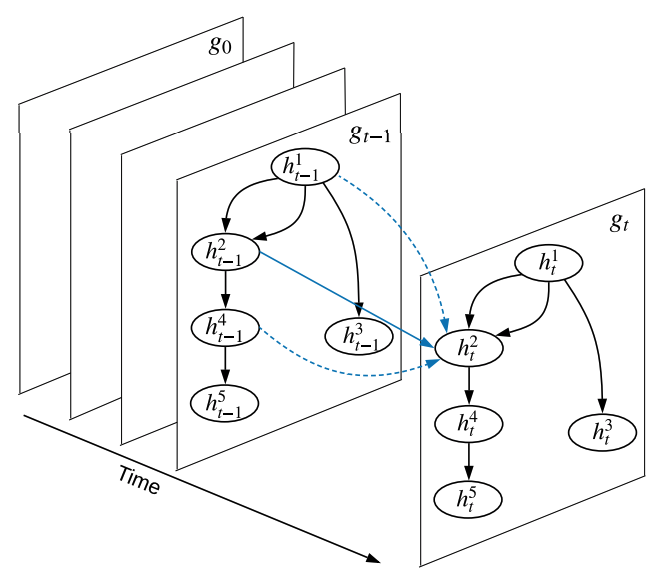
- 結果:BLEU スコアが従来手法 state-of-the-art より1.3ポイント向上。
- 概要:AMRグラフから意味情報を保ったままテキストを生成するモデルを提案。
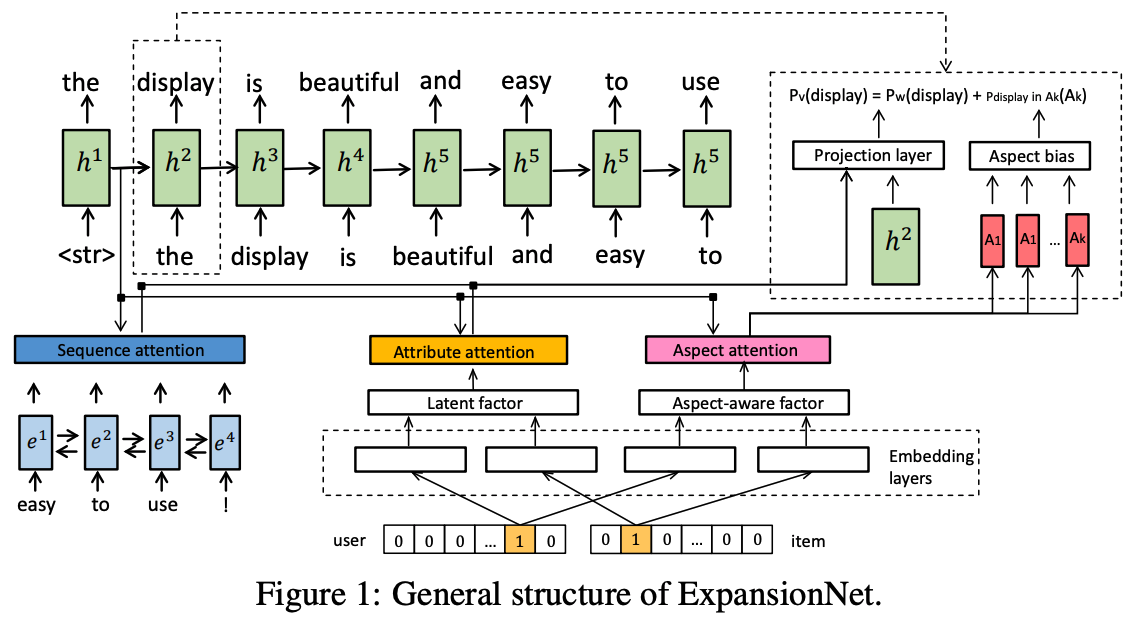
Personalized Review Generation By Expanding Phrases and Attending on Aspect-Aware Representations [Jianmo Ni+, ACL18]
- 概要:ユーザーに対するレビュー作成支援システムの構築。
- パーソナライズされたレビューの作成タスクを、user, item, short phrase が与えられる時に、それらを考慮して生成するタスクとして定義。
- 手法:アスペクトを考慮した表現を学習することによって、user, item のアスペクトに関する嗜好を捉えたレビュー生成が可能。
- アスペクトを考慮した表現から求めた attention によって生成を制御。
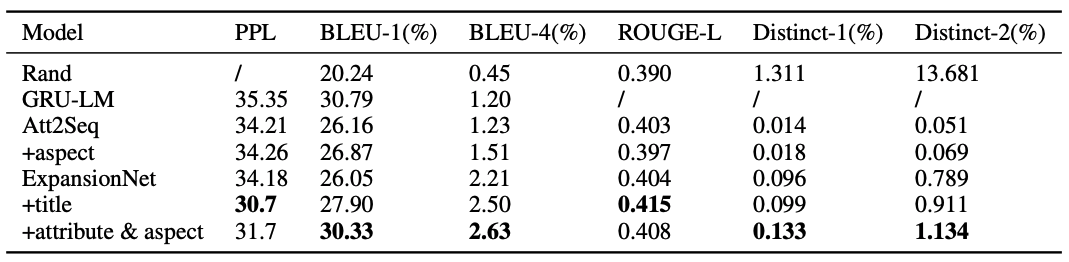
- 結果:
- 概要:ユーザーに対するレビュー作成支援システムの構築。
Mixed Feelings: Natural Text Generation with Variable, Coexistent Affective Categories [Lee Kezar, ACL18(Student Research Workshop)]
- 概要:複数の感情を語に含めた上でテキスト生成を行う。
- 手法:単語に対して joy / sadness / fear / anger の4つの感情を0~1のレンジで組み込んで、テキスト生成を行う。
- 結果:手法の提案のみで検証実験はまだ。
Automatic Question Generation using Relative Pronouns and Adverbs [Payal Khullar+, ACL18(Student Research Workshop)]
- 概要:構文解析情報を利用して文から質問文の自動生成を行う。
- 手法:文中の関係詞節に着目して、いくつかのルールに基づいて質問文を生成。
- 結果:構文解析情報を利用することで wh-word の活用が従来手法より正確。
言語処理学会2019での文生成系研究
フレーズ単位の発話応答ペアを⽤いた対話応答⽣成の多様化 [佐藤+, NLP19]
- 概要:英語文での応答文生成。
- 手法:PBMT と NMT を組み合わせたハイブリッドモデル。PBMT の多様性 + NMT の流暢性を狙う。
- 評価:BLUE 値はあまり落ちないが、多様性の向上は見られない。
- しかし、事例によっては PBMT の多様性がうまく働いている(現状では NMT に寄りすぎている)。
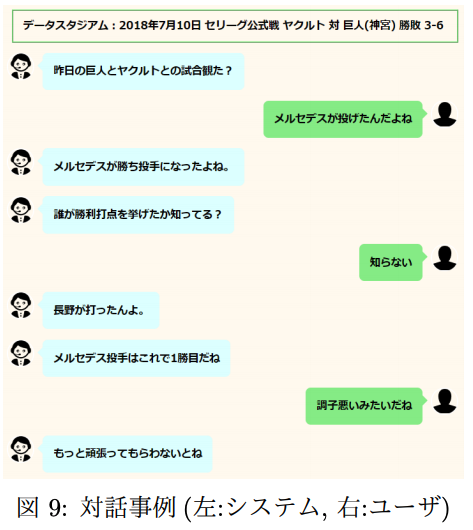
リアルタイム情報に対する時事雑談生成 [塚原+, NLP19]
- 概要:前日までの情報を用いた日本語雑談文の生成。ドメインはかなり制限している。
- 手法:Seq2Seq ではなく対話テンプレにクエリを埋める方式。対話テンプレは人手で作成。
- 評価:野球ドメインの雑談において意味のある対話が実現。
ユーザーの発話意図理解に基づくインタビュー発話の生成 [松好+, NLP19]
- 概要:高齢者へのインタビュー発話の生成。データ作成段階でシステムの実験結果はまだ。
- 手法:言語理解部・言語生成部からなる。
- LSTM Encoder-Decoderモデルを利用。
- 結果:実験は今後。
ダイレクト広告コピー文の分析と自動生成 [平良+, NLP19]
- 概要:サプリメント系商品の CM 227本を対象にコピー文の分析。CM 内での発話コマンド(コンテンツシート、発話者、発話内容、発話タイプ)からコピー文を生成する。今回は分析が主。自動生成実験は今後の課題。
- 分析:発話者、発話内容、発話タイプの3つの観点で分析。
- 手法:コピー文の生成方法として以下の4タイプを提案。
- 定型表現を生成する(商品固有情報を必要としない)
- コンテンツシートの項目の値をそのまま出力する
- テンプレートにコンテンツシートの項目の値を代入することによって生成する
- コンテンツシートの項目の値に基づいて、適切なテンプレートを選択して生成する
- 結果: コピー文の生成は可能だが、発話のみから構成されるコピー文は14(/227)本のみと少ないため、発話外からのコピー文の生成が必要。
キャッチコピーの⾃動⽣成に向けた分析 [丹羽+, NLP19]
- 概要:日本語キャッチコピーの分析。
- 手法:キャッチコピーの自動生成・制作支援のための、コーパス構築およびその分析と実験。キャッチコピー制作過程の単語穴埋め支援システムの試作。
- モデル:2層の BiLSTM エンコーダ + 入力側へのアテンション付きデコーダ
- 学習内容:キャッチコピーの名詞と動詞を1つずつ隠して、当てはまる単語を予測
- 結果:意味の通る生成自体は可能。単語反復などの修辞技法は捉えられていない。
対象に固有な特徴を捉えたキャッチコピー生成[三沢+, NLP19]
- 概要:Wantedly の募集要項からキャッチコピーを生成。Attention を用いることでより入力に固有の生成を行う。
- 手法:Attention 機構付き Encoder-Decoder モデル + 出力単語から入力単語を復元する機構
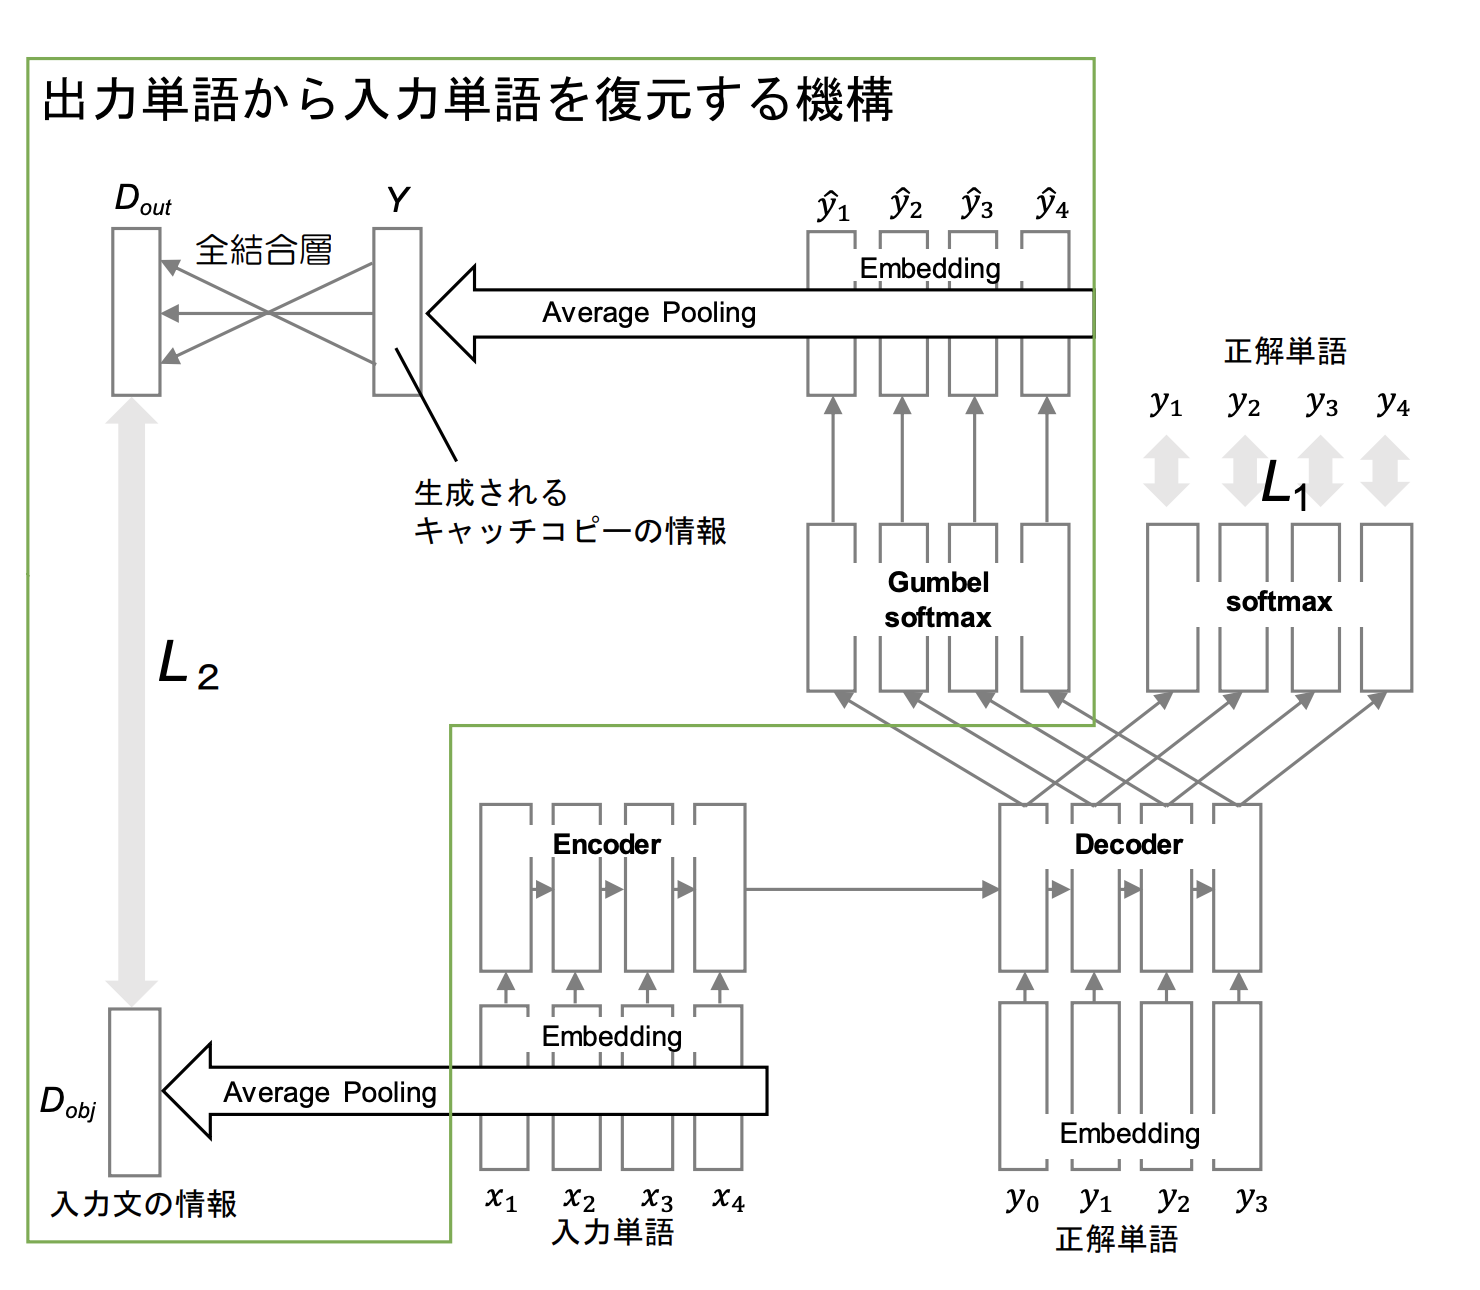
- 結果:従来モデルより提案手法の方が復元機構を加えたことにより特徴性が高い。
自己相互情報量を用いた特徴語彙予測に基づく雑談応答生成 [高山+, NLP19]
- 概要:Encoder-Decoder モデルでは頻出する文が出力されやすいという問題に対して、PMI の高い応答を返すことで改善を検証。
- 手法:
- PMI に基づいて入力発話と強く共起する特徴語彙を予測
- Gumbel-Softmax を用いてデコーダが出力した語彙をサンプリング
- 予測した特徴語彙のうち,デコーダが生成した語の割合を計算し,その値を損失関数に加える
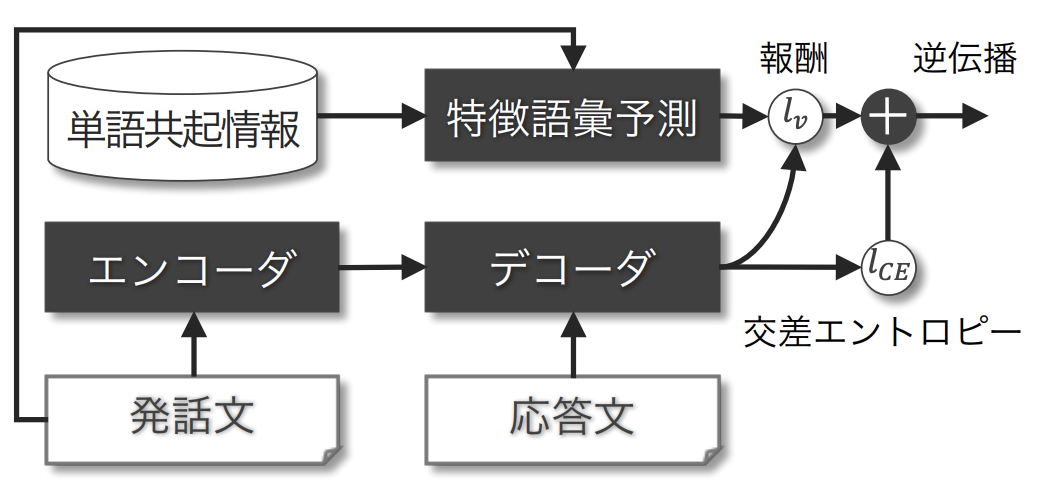
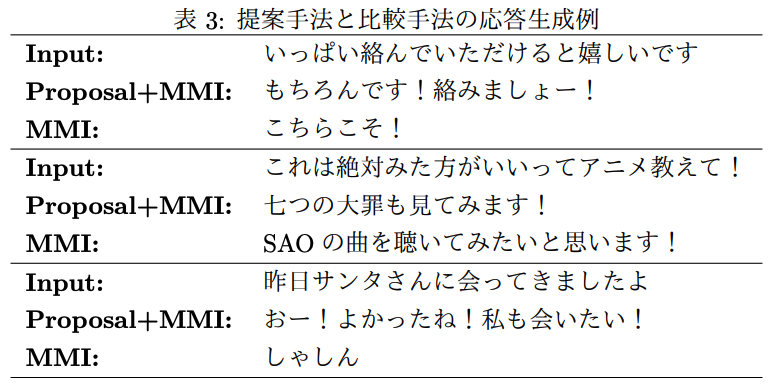
- 結果:従来手法に比べて提案手法の方が高い BLEU, NIST スコア。共起の強い単語の出力ができている。
まとめ
文生成研究の現状についての調査結果をまとめます。
- 文生成の現状として、Encoder-Decoder モデル等により生成した文の流暢性は確保できるが、頻出する文(正解しやすい文)が出力されやすくなってしまう問題が多く報告されている。
- その改善のための、流暢性と多様性のどちらも成立できるモデルの研究が増えてきている。
- コンテキストを含んだ長い文書(ストーリー系)の生成はまだ人間程度には遠い。
- 調査をして改めて日本語は英語と比較して数歩進展が遅い印象を受けた。
- 英語データセットの豊富さを確認。
- 日本語の大規模データセットはかなりの貢献になる。
プロダクトの観点から
- 2019年現在の技術ではパーソナライズしたスカウト文を生成することは難しい。
- LAPRAS SCOUT では、現在は文の生成ではなくメールのチェックにAIを利用している(機械学習技術によるスカウトメールのクオリティフィルタ)。
- 将来的には、AI(LAPRAS)が信頼し合える友人のように個人の新しい生き方を提案してくれるような世界観を実現したい。
おわりに
本記事では、文生成研究の現状について調査してまとめました。我々は、 LAPRAS の提供している LAPRAS SCOUT でのスカウトメール生成において、候補者に強くパーソナライズした文の生成が重要であると考えています。現在の主流となっている Encoder-Decoder モデルを基にした技術では、文自体の流暢性は担保できますが、パーソナライズという観点においては完全に自動で文を生成することは難しいと判断しました。今後 LAPRAS リサーチチームとしては、特徴を捉えた文生成が行えるモデルを日本語に適用して検証を行い、パーソナライズされた文の作成を支援する枠組みの導入を検討予定です。

